打开网站时突然看到:
502 Bad Gateway
或者:
502 Bad Gateway
nginx
很多人第一反应是“网站服务器挂了”。
这种判断并不完全准确。
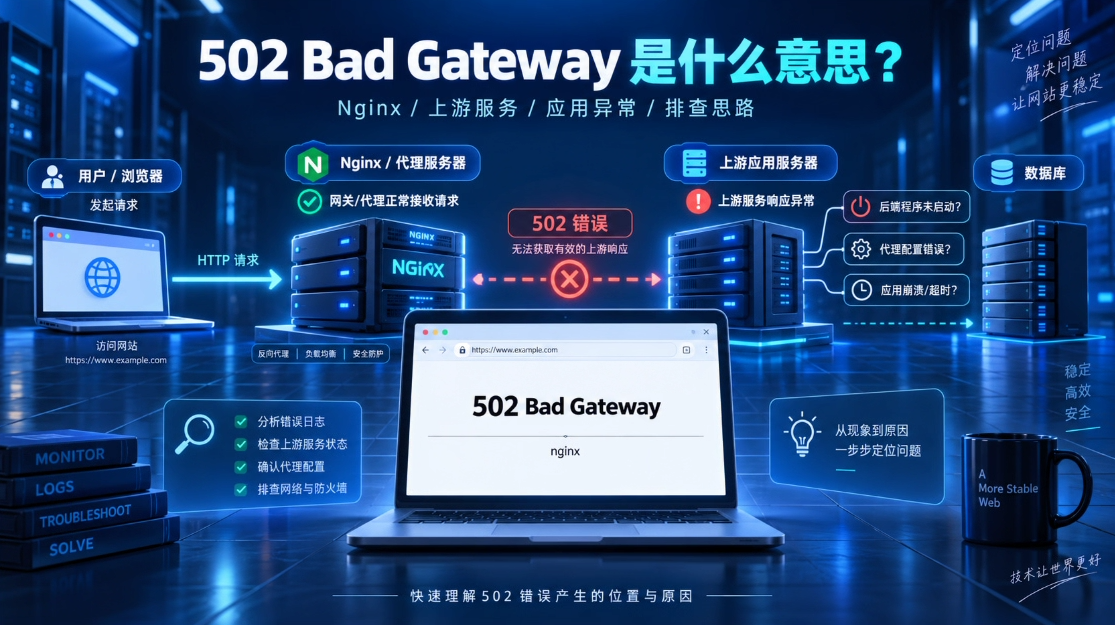
502 属于 HTTP 5xx 服务端错误,但它通常不是浏览器本身出现问题,而是网站访问链路中的代理服务器与上游服务器之间发生了异常。
例如一个常见的网站架构:
用户浏览器
    ↓
Cloudflare / CDN
    ↓
Nginx
    ↓
Go / Rust / Java / Node.js / PHP
    ↓
MySQL / PostgreSQL / Redis
只要代理服务器无法从下一层服务获得有效响应,就有可能出现 502 Bad Gateway。
下面我们从 502 的含义开始,详细分析它为什么发生,以及站长应该按照什么顺序排查。
一、502 Bad Gateway是什么意思?
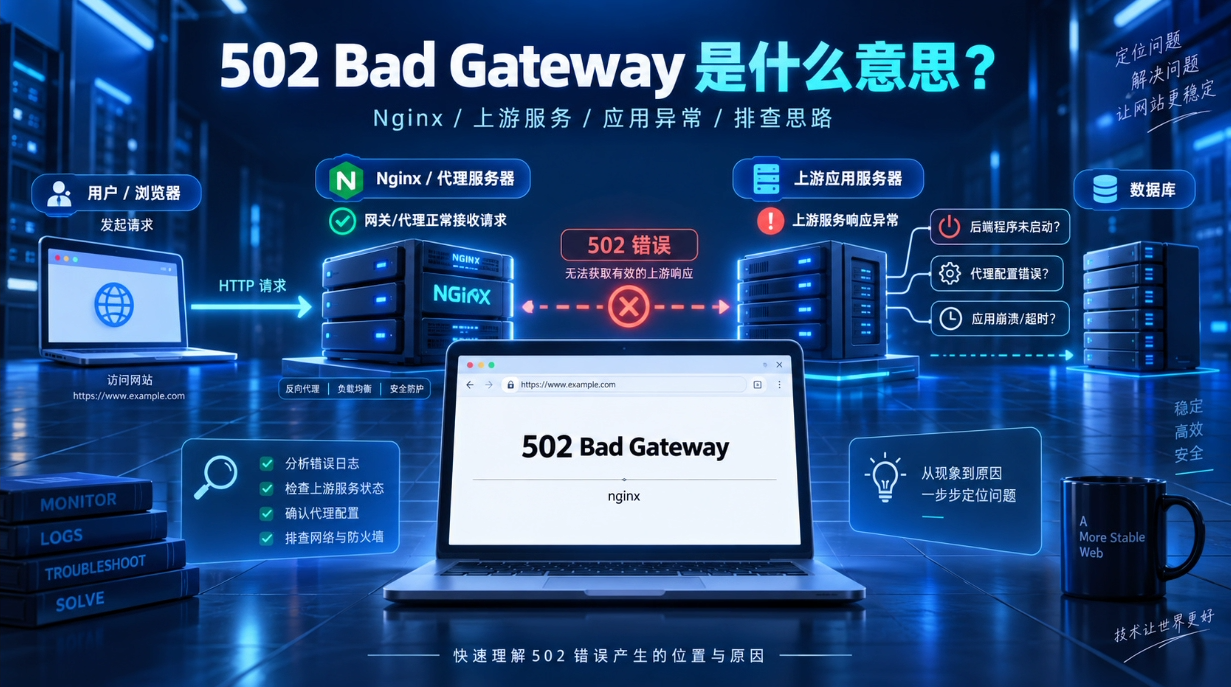
502 Bad Gateway 是一个 HTTP 服务端错误状态码。
简单理解:
前面的服务器正常收到了你的请求,但是它访问后面的服务器时出现了问题。
例如:
浏览器 → Nginx → Node.js
浏览器能够成功连接 Nginx。
但是 Nginx 再去访问 Node.js 时,Node.js 服务已经停止。
于是就可能出现:
502 Bad Gateway
因此,看到 502 时至少可以得到一个非常重要的信息:
当前返回 502 的服务器通常仍然能够处理 HTTP 请求,真正的问题可能发生在它与上游服务之间。
二、502错误是怎么产生的?
可以通过一个实际架构理解。
假设网站运行结构是:
用户
 ↓
Nginx :443
 ↓
Rust API :9527
 ↓
PostgreSQL
Nginx 配置:
location / {
    proxy_pass http://127.0.0.1:9527;
}
正常情况下:
用户请求
↓
Nginx收到请求
↓
Nginx连接127.0.0.1:9527
↓
Rust返回HTTP响应
↓
Nginx把响应返回给用户
但如果 Rust 程序崩溃了:
Nginx
↓
127.0.0.1:9527
↓
连接失败
Nginx 无法获得正常的上游响应,就可能向浏览器返回:
502 Bad Gateway
这也是生产环境中最常见的 502 场景之一。
三、502 Bad Gateway最常见的原因
导致 502 的原因很多,但实际排查时主要集中在以下几类。
1. 后端程序没有启动
这是最常见的原因之一。
例如 Nginx 配置:
proxy_pass http://127.0.0.1:8080;
但是 8080 根本没有程序监听。
可以检查:
ss -lntp | grep 8080
或者:
lsof -i :8080
如果没有任何结果,就需要检查后端程序是否已经停止。
例如:
systemctl status myapp
Docker 环境可以检查:
docker ps
2. Nginx代理端口配置错误
例如程序实际监听:
127.0.0.1:9527
但 Nginx 写成:
proxy_pass http://127.0.0.1:9528;
这种情况下 Nginx 本身完全正常,但是连接不到后端。
因此遇到 502 时应该同时确认两件事:
后端实际监听端口
和:
Nginx proxy_pass配置端口
是否一致。
3. 后端程序崩溃
网站刚启动时可以正常访问,但是运行一段时间后突然出现 502,这种情况需要重点检查后端程序。
可能原因包括:
- 程序 Panic
- 未处理异常
- 内存不足
- OOM Killer 杀死进程
- 数据库异常导致程序退出
- 配置文件错误
- 第三方服务异常
- 文件描述符耗尽
- 连接池耗尽
例如 Linux 可以查看:
journalctl -u myapp -n 200
如果使用 systemd:
systemctl status myapp
检查程序是否存在:
failed
panic
killed
out of memory
等错误。
四、Nginx出现502怎么排查?
如果错误页面底部明确显示:
nginx
通常应该首先查看 Nginx 错误日志。
常见位置:
/var/log/nginx/error.log
可以执行:
tail -n 100 /var/log/nginx/error.log
实时观察:
tail -f /var/log/nginx/error.log
然后重新访问出现 502 的页面。
Nginx 日志往往能直接告诉你问题发生在哪里。
五、出现Connection refused是什么意思?
如果日志中看到类似:
connect() failed (111: Connection refused) while connecting to upstream
这是非常典型的 502。
通常表示:
Nginx 尝试连接上游服务,但是目标端口没有接受连接。
例如配置:
proxy_pass http://127.0.0.1:9527;
那么立即执行:
ss -lntp | grep 9527
如果没有监听,则基本可以确认:
Nginx正常
↓
后端9527没有正常运行
↓
502
解决方法通常是重新启动后端服务并进一步调查它为什么停止。
六、upstream prematurely closed connection是什么意思?
还有一种常见日志:
upstream prematurely closed connection
它通常意味着:
Nginx 已经连接到了后端,但是后端在完整响应返回之前关闭了连接。
这时就不能简单判断为“端口没开”。
应该重点检查:
- 后端程序错误日志
- 程序是否崩溃
- 请求是否触发异常
- 请求体是否过大
- 内存是否不足
- 上游应用是否主动断开连接
- 应用自身超时设置
尤其是:
只有某个接口出现 502,而其他页面正常
这种情况下,很可能是特定业务接口导致后端异常。
七、如何快速判断后端服务是否正常?
假设 Nginx 代理的是:
127.0.0.1:9527
可以绕过 Nginx,直接访问后端:
curl -v http://127.0.0.1:9527/
如果返回:
HTTP/1.1 200 OK
说明后端至少能够正常响应这个请求。
如果显示:
Connection refused
就说明后端端口没有正常提供服务。
这种排查方法非常有效。
因为它可以迅速判断:
用户 → Nginx
这一层的问题,还是:
Nginx → 后端
这一层的问题。
八、Docker环境为什么容易出现502?
使用 Docker 部署网站时,也经常遇到 502。
一个常见错误是:
proxy_pass http://127.0.0.1:3000;
但 Nginx 和应用实际上运行在不同 Docker 容器中。
这时候:
127.0.0.1
代表的是 Nginx 容器自身,并不是应用容器。
例如:
nginx容器
app容器
postgres容器
通常应该通过 Docker 网络和服务名称连接:
proxy_pass http://app:3000;
具体写法取决于 Docker Compose 和网络配置。
Docker环境排查命令
查看容器:
docker ps
查看日志:
docker logs app
查看最近日志:
docker logs --tail 100 app
查看容器网络:
docker network ls
如果容器不断重启:
Restarting
就需要进一步查看应用启动日志。
九、Cloudflare出现502是什么意思?
使用 Cloudflare、CDN 或其他反向代理服务的网站,访问链路通常会变成:
用户
↓
Cloudflare / CDN
↓
源站Nginx
↓
后端程序
这时问题就可能发生在更多位置。
例如:
情况1:CDN访问源站异常
用户
↓
CDN正常
↓
源站异常
情况2:源站Nginx正常,但是后端异常
CDN
↓
Nginx
↓
应用程序异常
情况3:源站返回了异常响应
CDN 最终向用户显示 502 页面。
所以使用 CDN 后看到 502,不应该只检查 CDN。
还应该检查:
- DNS
- 源站IP
- 80/443端口
- Nginx
- 应用程序
- 防火墙
- CDN回源配置
十、如何判断到底是CDN问题还是源站问题?
一种常见方法是直接测试源站。
假设域名:
www.example.com
源站 IP:
203.0.113.10
可以先测试服务器端口是否可以连接。
重点检测:
203.0.113.10:80
和:
203.0.113.10:443
如果源站 TCP 端口已经无法连接,那么应该优先排查:
- 服务器是否在线
- Nginx是否运行
- 安全组
- 防火墙
- 网络线路
可以使用多地区 TCP 检测工具进一步确认究竟是所有节点无法连接,还是只有部分地区出现异常。
十一、502和504有什么区别?
502 和 504 经常被混淆。
两者都可能发生在:
代理服务器 → 上游服务器
这条链路中。
但是含义有所不同。
状态码含义502 Bad Gateway网关或代理从上游获得了无效响应504 Gateway Timeout网关或代理等待上游响应超时
简单理解:
502
更接近:
上游响应不正常
例如:
Nginx → 应用连接失败
或者:
上游提前关闭连接
504
更接近:
上游一直没有及时响应
例如:
Nginx
↓
API正在执行超慢SQL
↓
迟迟没有返回
↓
504
所以出现 504 时,需要更加关注:
- 慢 SQL
- API执行时间
- 第三方接口超时
- proxy_read_timeout
- 数据库锁
- 后端性能
十二、502和500有什么区别?
500 Internal Server Error 一般表示:
服务器处理请求时发生内部错误
例如:
PHP报错
Node.js异常
Java异常
数据库错误
业务逻辑错误
而 502 更强调:
代理 / 网关
↓
上游服务
之间出现异常。
可以粗略理解为:
500:当前应用自己报错
502:代理访问后端时出问题
但实际生产环境仍应结合日志判断,而不能只根据状态码猜测。
十三、502和503有什么区别?
503 Service Unavailable 通常表示:
服务当前暂时无法处理请求。
比较常见的场景包括:
- 系统维护
- 服务过载
- 服务临时不可用
- 后端主动进入维护状态
而 502 更侧重网关或代理与上游之间获得无效响应。
因此:
500
502
503
504
虽然都属于 5xx 服务端错误,但排查方向并不完全相同。
十四、服务器CPU和内存过高会导致502吗?
可能。
例如服务器内存已经耗尽:
Memory 100%
Linux OOM Killer 可能直接杀死后端程序。
于是:
Nginx正常
↓
后端进程被杀
↓
端口消失
↓
502
因此,如果网站原本长期运行正常,却突然出现 502,可以检查:
free -h
查看内存:
top
或者:
htop
查看 CPU 和进程。
查看磁盘:
df -h
还可以检查内核日志:
dmesg | grep -i -E 'oom|killed process|out of memory'
如果发现 OOM,则要继续分析:
- 是否存在内存泄漏
- 应用是否需要限制内存
- 并发是否突然增加
- worker数量是否过高
- 数据库连接池是否配置过大
十五、数据库故障会不会导致502?
数据库异常本身不一定直接产生 502。
正常设计的应用可能返回:
500 Internal Server Error
但是如果数据库问题进一步导致应用:
- 崩溃
- 退出
- 卡死
- 关闭连接
- 无法启动
那么 Nginx 无法获得有效的应用响应,就可能最终表现为 502。
例如:
PostgreSQL停止
↓
后端启动失败
↓
后端9527端口不存在
↓
Nginx连接失败
↓
502
因此,排查后端程序时还应该检查其依赖:
- PostgreSQL
- MySQL
- Redis
- Elasticsearch
- 消息队列
- 对象存储
- 第三方API
十六、只有部分页面502是什么原因?
这种现象非常关键。
如果:
首页:200
登录页:200
商品页:200
支付接口:502
说明网站整体服务器大概率没有完全宕机。
应该重点排查出现问题的那个接口。
例如:
/api/payment
可能涉及:
Nginx
↓
API
↓
支付服务
↓
数据库
↓
第三方接口
任何一环异常,都可能导致这个接口最终失败。
建议同时查看:
Nginx日志
tail -f /var/log/nginx/error.log
应用日志
journalctl -u myapp -f
然后再次触发问题请求。
这样通常最快能够找到原因。
十七、只有部分地区出现502怎么排查?
如果自己访问正常,但是用户反馈其他地区出现 502,就不能只在本地电脑测试。
可能涉及:
- CDN节点异常
- 地区线路异常
- 不同DNS解析结果
- 多源站配置
- IPv4 / IPv6差异
- 不同运营商访问路径
- CDN回源策略
例如:
深圳电信:200
广州移动:200
北京联通:502
上海电信:502
这时候非常适合使用多地区 HTTP 状态检测、TCP 检测和 DNS 查询进行对比。
先确认:
不同地区到底返回什么HTTP状态码?
然后继续检查:
这些地区解析到的是不是同一个IP?
以及:
源站443端口是否都可以连接?
这样比只在服务器上查看一次状态更加有效。
十八、502 Bad Gateway完整排查流程
遇到 502 时,可以直接按照下面的顺序检查。
第一步:检查是不是所有用户都502
分别使用:
- 本地宽带
- 手机流量
- 不同地区节点
进行测试。
如果只有自己出现,首先排查本地网络和代理。
如果所有节点都出现,继续检查服务器。
第二步:检测HTTP状态码
确认服务器真实返回的是:
502
还是:
500
503
504
403
不同状态码的排查方向并不一样。
可以通过 HTTP 状态检测工具从多个节点验证。
第三步:检查80/443端口
检测:
域名:80
域名:443
如果 443 都无法建立 TCP 连接,那么当前问题可能还没有进入 HTTP 层。
应优先检查:
- Nginx
- 防火墙
- 安全组
- CDN
- 网络
第四步:检查Nginx
执行:
systemctl status nginx
检查配置:
nginx -t
查看日志:
tail -n 100 /var/log/nginx/error.log
第五步:确认上游地址
检查:
proxy_pass
例如:
proxy_pass http://127.0.0.1:9527;
然后检查:
ss -lntp | grep 9527
第六步:直接访问后端
例如:
curl -v http://127.0.0.1:9527/
判断应用能否脱离 Nginx 独立响应。
第七步:查看应用日志
例如:
journalctl -u myapp -n 200
Docker:
docker logs --tail 200 app
重点寻找:
panic
error
fatal
timeout
connection refused
out of memory
等异常。
第八步:检查服务器资源
top
free -h
df -h
判断 CPU、内存和磁盘是否异常。
第九步:检查数据库等依赖
确认:
PostgreSQL
MySQL
Redis
消息队列
第三方API
是否正常。
十九、502快速诊断表
现象优先排查Nginx直接显示502Nginx错误日志Connection refused后端进程、端口后端端口不存在应用是否启动后端curl正常但域名502Nginx代理配置容器部署后出现502Docker网络、服务名重启应用后恢复应用崩溃原因高并发时出现502应用负载、资源、连接数部分接口502对应接口和应用日志部分地区502CDN、DNS、节点线路CDN开启后502CDN到源站链路内存100%后502OOM、应用被杀数据库故障后502应用启动和数据库连接
二十、用户遇到502可以自己解决吗?
如果你只是网站访客,502 通常不是通过刷新浏览器缓存就能够真正解决的问题。
可以尝试:
- 刷新页面
- 稍后重新访问
- 切换网络
- 关闭异常代理或VPN
- 确认其他网站是否正常
如果其他用户也出现相同的 502,则问题大概率需要由网站管理员处理。
如果你是站长,则应该从:
HTTP状态
↓
TCP端口
↓
Nginx
↓
上游应用
↓
数据库与依赖
逐层检查。
二十一、如何降低网站再次出现502的概率?
解决一次 502 并不代表问题真正消失。
如果生产环境经常发生 502,应该继续寻找根因。
建议重点做好以下几项。
1. 给后端服务配置自动重启
使用:
systemd
Docker restart policy
Kubernetes
Supervisor
PM2
等机制保证异常退出后能够恢复。
2. 做健康检查
定期检查:
HTTP状态
TCP端口
应用健康接口
例如提供:
/health
健康检查接口。
3. 做资源监控
长期监控:
- CPU
- 内存
- 磁盘
- 带宽
- 数据库连接
- 请求量
- 5xx比例
4. 保存错误日志
至少应该保留:
Nginx日志
应用日志
数据库日志
系统日志
否则故障恢复后很难追踪真正原因。
5. 做多节点检测
服务器本机正常,并不代表所有用户访问都正常。
通过不同地区进行:
- Ping 检测
- TCP 检测
- DNS 查询
- HTTP 状态检测
- 网站测速
可以更早发现区域性异常。
二十二、502 Bad Gateway常见问题FAQ
502 Bad Gateway是网站被攻击了吗?
不一定。
502 本身只能说明代理或网关与上游响应之间存在异常,并不能仅凭状态码判断网站遭受攻击。
后端程序停止、配置错误、服务器资源耗尽等都可能产生 502。
重启Nginx可以解决502吗?
有时可以,但不建议把它当成固定解决方案。
如果真正的问题是:
后端程序已经停止
那么重启 Nginx 并不能解决根因。
应该首先查看 Nginx error.log。
重启服务器后502消失了,还需要处理吗?
建议继续排查。
服务器重启可能同时恢复了:
- Nginx
- 后端应用
- 数据库连接
- 内存资源
但并没有解释最初为什么出现故障。
如果不寻找原因,同样的问题可能再次发生。
502会影响SEO吗?
偶发、短时间的服务异常与网站长期持续返回 502 是完全不同的情况。
如果搜索引擎访问页面时长期、多次遇到服务器错误,会影响正常抓取和页面可用性。
因此生产网站出现持续性 5xx 错误应该尽快处理。
502和504哪个更严重?
不能仅根据状态码判断哪个“更严重”。
两者代表不同类型的问题。
502 更偏向代理获得无效的上游响应,504 更偏向等待上游响应超时。
真正严重程度取决于持续时间、影响范围以及具体故障原因。
总结
看到:
502 Bad Gateway
不要第一时间反复修改 Nginx 配置,也不要简单认为“服务器挂了”。
502 最核心的排查思路是理解请求链:
用户
↓
CDN
↓
Nginx
↓
应用程序
↓
数据库
然后逐层检查。
推荐按照:
HTTP状态
↓
TCP 80/443
↓
Nginx错误日志
↓
proxy_pass地址
↓
后端监听端口
↓
应用日志
↓
CPU/内存/磁盘
↓
数据库及其他依赖
进行排查。
如果只是单个地区或者部分运营商出现异常,则进一步结合多节点 HTTP 状态检测、DNS 查询、Ping、TCP 检测和网站测速,对比不同节点的结果。
真正解决 502 的关键并不是“重启一下”,而是确定到底是哪一层无法向上一层提供有效响应。
一旦找到这一层,502 Bad Gateway 通常就会从一个看起来很复杂的问题,变成一个可以逐步定位的具体故障。